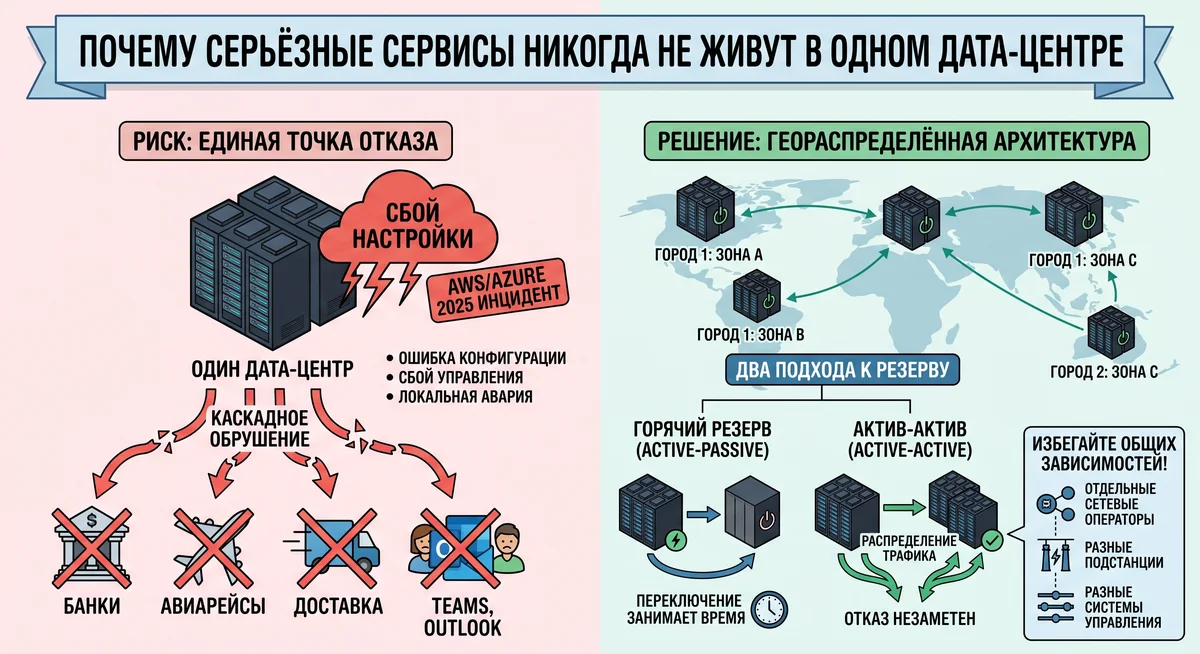
Прошлой осенью интернет дважды за десять дней напомнил, что «облако» — это на самом деле обычные здания с серверами. Сначала, 20 октября 2025 года, отказал один регион AWS в Северной Вирджинии — и разом посыпались больше сотни сервисов по всему миру: доставка, банки, регистрация на авиарейсы. Не прошло и девяти дней, как то же самое повторилось у Microsoft Azure: встали Teams, Outlook, Xbox и стойки регистрации целых авиакомпаний. Причиной в обоих случаях стали не хакеры и не пожар, а одна ошибочная настройка, которая каскадом обрушила всё остальное.
Вывод отсюда простой. Один дата-центр — это всегда единая точка отказа, даже если он оснащён по высшему разряду, с резервным питанием и охлаждением. От ошибки в конфигурации или сбоя, накрывшего весь регион, не защитит ни один источник бесперебойного питания. Инженеры умеют строить исключительно надёжные объекты, но абсолютной надёжности не существует, и рано или поздно это даёт о себе знать.
Поэтому серьёзные проекты не полагаются на одну площадку, а распределяют нагрузку сразу по нескольким дата-центрам. Начинают с дублирования оборудования в пределах одного зала, затем разносят его по разным зданиям в городе — это называют зонами доступности, — а на самом ответственном уровне разводят по разным городам и странам, чтобы никакая локальная авария не могла задеть обе площадки одновременно.
Как связать площадки
Первый подход: основная работает, а вторая находится в горячем резерве и подхватывает нагрузку, если первая вышла из строя. Это дешевле, но переключение занимает время, и его необходимо регулярно отрабатывать. Резерв, который ни разу не проверяли под нагрузкой, — это не резерв, а всего лишь надежда. Второй подход: обе площадки работают одновременно и делят трафик, так что падение одной проходит почти незаметно. Надёжнее, но и заметно дороже.
Неочевидный момент
Резерв, у которого с основной площадкой есть общая зависимость, на самом деле уже не резерв. Именно с этим столкнулись многие прошлой осенью: серверы стояли в разных регионах, но опирались на одну и ту же систему управления провайдера — стоило ей отказать, и география не выручила. Бывает и проще: две площадки от одной подстанции или два канала от одного оператора. На бумаге — резерв, а по факту общая слабая точка, которая тянет за собой обе.
Вывод
В сухом остатке геораспределение — это не про перестраховку и не про количество площадок ради солидности, а про здравый расчёт: понять, во сколько обходится час простоя, и вложиться в независимость ровно настолько, насколько это оправдано. Настоящая отказоустойчивость держится на двух простых вещах: у площадок не должно быть общей точки отказа, а переключение между ними стоит проверить заранее, в спокойной обстановке, а не в разгар аварии.
Хорошая новость в том, что всё это — вопрос не столько бюджета, сколько продуманной архитектуры. И выстроить её вполне по силам, если подумать об этом заранее.
А как этот вопрос решён у вас — держите проект на одной площадке или уже присматриваетесь к резервной?