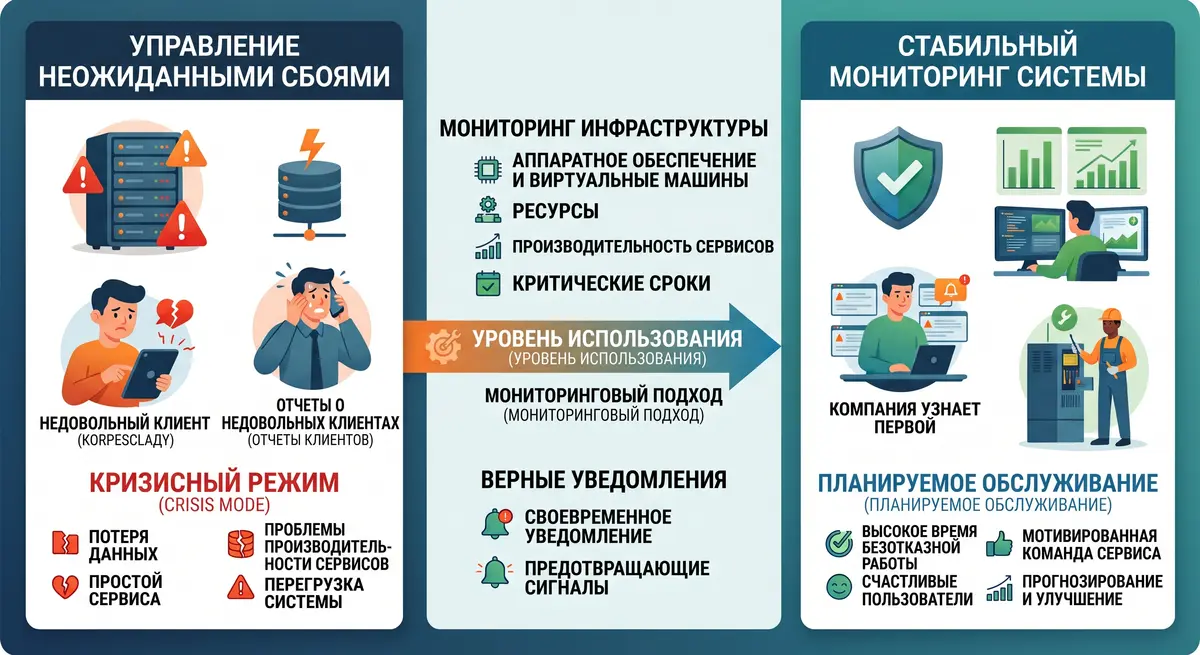
Существует два способа узнать, что сервис недоступен. Первый — об этом сообщит недовольный клиент. Второй — компания узнаёт об этом самостоятельно, ещё до того, как проблему заметит кто-либо снаружи. Расстояние между этими сценариями и определяет зрелость эксплуатации, а обеспечивает его мониторинг.
Несмотря на очевидность идеи, значительная часть компаний работает по первому сценарию. Пока сервер функционирует, в его состояние никто не заглядывает — до момента отказа. А когда отказ происходит, выясняется, что дисковое пространство исчерпывалось постепенно в течение недели, объём свободной памяти сокращался месяцами, а срок действия сертификата истёк накануне. Все эти события можно было увидеть заранее.
Что означает контроль состояния инфраструктуры
Мониторинг — это не сотрудник, наблюдающий за графиками, а автоматизированная система, которая непрерывно проверяет ключевые показатели и сигнализирует при выходе значений за допустимые пределы. Контролировать имеет смысл несколько уровней. Доступность самого оборудования и виртуальных машин. Ресурсы — свободное место на дисках, объём памяти, загрузку процессора. Работоспособность прикладных сервисов — сайта, базы данных, почты — и скорость их отклика. Наконец, приближение критичных сроков, таких как окончание действия SSL-сертификата или регистрации домена.
Ценность не в графиках, а в оповещениях
Здесь кроется распространённая ошибка. Компании внедряют систему с наглядными панелями и графиками — и затем в неё не заглядывают. Однако смысл мониторинга не в возможности наблюдать за состоянием, а в способности своевременно уведомить ответственных, когда требуется вмешательство. Корректно настроенное оповещение — в мессенджер, на почту или звонком — значительно важнее визуализации, к которой никто не обращается. Система должна сообщать о проблеме сама, и тогда компания узнаёт о ней первой.
Более высокий уровень — предупреждение до отказа
Зрелый мониторинг сигнализирует не о свершившемся сбое, а о приближающемся. Например: при текущей динамике дисковое пространство будет исчерпано в течение трёх суток; объём занятой памяти устойчиво растёт; срок действия сертификата истекает через неделю. Такой подход переводит эксплуатацию из режима устранения аварий в режим планового обслуживания, когда проблема решается в рабочее время, а не в аварийном порядке.
С чего начать
Выстраивать сложную систему сразу не требуется. Разумно начать с одного-двух наиболее критичных сервисов и настроить базовую проверку доступности с оповещением ответственного лица. Подходящих инструментов достаточно, в том числе бесплатных решений с открытым исходным кодом — от простых средств проверки доступности до полнофункциональных платформ. Даже базовый контроль переводит компанию из категории «узнаёт о сбоях от клиентов» в категорию «узнаёт первой».
Репутация надёжного сервиса строится не на отсутствии сбоев — они случаются у всех, — а на способности обнаружить проблему раньше клиента и устранить её до того, как она отразится на пользователях.